'기업 비밀 샐라' AI 정보유출·해킹 뚫리는 문제, 서울시립대 연구진이 잡았다
[파이낸셜뉴스] 기업에서 생성형 인공지능(AI)을 도입할 때 가장 큰 걸림돌로 꼽히던 '민감 정보 유출'과 '보안망 우회(해킹)' 문제를 동시에 해결할 수 있는 기술이 국내 연구진에 의해 개발됐다.
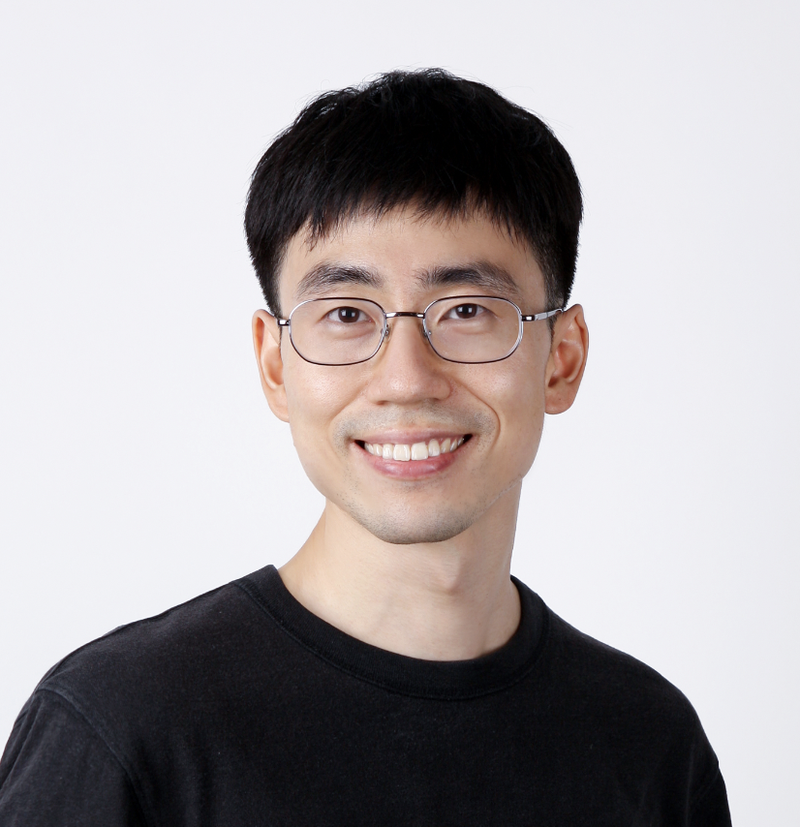
서울시립대학교는 인공지능학과 황원석 교수팀이 개발한 대규모 언어모델(LLM) 안전성 관련 연구 논문 2편이 세계 최고 권위의 자연어처리 학술대회인 'EMNLP 2026'에 동시 채택됐다고 11일 밝혔다.
첫 번째 연구인 '큐캣(Q-CAT)' 시스템은 기업 내부의 계약 조건, 급여 정보, 소송 관련 문서 등 민감한 정보가 AI를 통해 외부로 새어 나가는 것을 실시간으로 차단하는 기술이다. 기존에는 보안 규칙이 바뀔 때마다 덩치가 큰 AI 전체를 처음부터 다시 학습시켜야 해 막대한 시간과 비용이 들었다. 연구팀은 AI를 재학습시키는 대신, 관리자가 입력한 보안 규칙에 따라 금지·허용 질문 예시를 자동으로 만들고 사용자의 질문과 실시간으로 비교하는 방식을 도입했다. 그 결과 추가 학습 비용 없이도 기존 대형 AI 모델보다 정확도는 높이면서 처리 속도는 최대 수백배까지 빨라졌다.
두 번째 연구는 AI의 안전장치를 뚫는 해킹 기술을 분석하고 이를 막아내는 방어책('세티스·THETIS')에 관한 것이다. 연구팀은 AI가 위험한 요청을 거절할 때 대부분 영어 단어 'I(나)'로 문장을 시작한다는 점에 착안했다. 연구 결과 거절 응답의 88%가 이 단어로 시작됐으며, 해커들이 이 거절 패턴을 역이용하면 90% 이상의 확률로 AI의 보안 장치를 무력화할 수 있다는 사실을 밝혀냈다. 연구팀은 이에 대한 방어책으로 AI가 명시적인 거절 문구를 남기는 대신, 위험하지 않은 일반 정보로 자연스럽게 답변을 돌려 피하도록 학습 데이터셋을 새로 구축했다. 이 기술을 적용하자 해킹 공격 성공률이 0%에 가깝게 낮아졌다.
이번 연구는 1만 7000편이 넘는 논문이 제출된 세계적 학술대회에서 기술의 우수성과 실용성을 동시에 인정받았다. 연구를 이끈 황원석 서울시립대 교수는 "기업들이 생성형 AI를 실제로 활용할 때 부딪히는 실질적인 보안 문제와 구조적 취약점을 다각도로 해결하고자 했다"며, "앞으로도 안전하고 신뢰할 수 있는 AI 기술 대안을 계속 제시하겠다"고 말했다.
[email protected] 김만기 기자