KAIST, 입모양 알아듣는 AI 정확도 높였다...EMNLP 우수논문상
[파이낸셜뉴스] 국내 연구진이 시끄러운 곳에서 입모양만으로 상대의 말을 정확히 알아듣는 인공지능(AI) 기술을 개발했다. 소음에 묻힌 말을 문자로 전달하거나 청각장애인·난청인의 대화를 돕는 소통 기술로 활용될 것이라는 기대다.
KAIST(한국과학기술원)는 전기및전자공학부 노용만 교수 연구팀이 입술 움직임을 보고 말을 문자로 바꾸는 '시각적 음성 인식(Visual Speech Recognition, VSR)'의 정확도를 높이는 기술을 개발했다고 15일 밝혔다.
연구팀은 문장의 빈칸을 반복해서 채워나가는 '확산 대형 언어 모델(Diffusion Large Language Model, DLLM)'을 활용해, 입모양이 모호한 부분을 앞뒤 문맥으로 해독하도록 했다. 기존에 널리 쓰이던 AI는 문장을 첫 단어부터 순서대로 만들어, 앞부분에서 잘못된 단어를 선택하면 그 오류가 뒤따르는 문장에도 영향을 줄 수 있었다.
연구팀은 '처음부터 순서대로 읽기'를 '확실한 부분부터 읽기'로 바꿨다. 입술 움직임이 분명한 단어를 먼저 알아낸 뒤, 그 단어들을 단서로 남은 부분을 해독하는 방식이다. 퍼즐에서 모양이 분명한 조각부터 맞추고 주변 조각을 채우듯, 문장의 앞뒤 정보를 함께 살피며 모호한 부분을 점차 풀어낸다.
학습 방식도 개선했다. 먼저 영상 속 입술 움직임과 글자 내용을 연결하도록 가르친 뒤, 문장의 길이를 학습하도록 두 단계를 나눴다. 또 실제 말을 해독할 때는 영상 길이를 바탕으로 가능한 문장 길이를 여러 개 추정하고, 각 결과를 비교해 더 신뢰할 만한 문장을 선택하도록 했다.
그 결과, 연구팀은 433시간 분량의 입모양 영상 데이터셋 'LRS3'를 정답이 제공되는 학습 데이터로 활용해 단어 오류율 19.4%를 기록했다. 단어 오류율은 정답 문장과 비교해 단어를 잘못 인식하거나 빠뜨리거나 추가한 정도를 나타내며, 낮을수록 성능이 좋다. 이번 결과는 LRS3만 정답이 붙은 학습 데이터로 사용한 기존 방법들 가운데 가장 낮은 오류율이다.
이번 기술은 소리가 잘 들리지 않는 환경에서 입모양을 문자로 전달하는 의사소통 보조 기술에 활용될 수 있다. 예를 들어 기계 소음이 큰 산업 현장에서 작업자의 말을 파악하거나, 청각장애인·난청인의 대화를 돕는 기기로 발전시킬 수 있다는 설명이다.
연구팀은 향후 AI 모델의 크기와 연산량을 줄여 다양한 기기에 적용하는 연구를 이어갈 계획이다. 웨어러블 기기나 로봇에서 인터넷 연결 없이 실시간으로 작동하도록 하는 것이 후속 과제다.
노용만 교수는 "이번 연구는 인공지능이 단어를 생성하는 순서를 유연하게 제어하는 것만으로도 시각적 모호성을 지닌 음성 인식의 근본적 한계를 극복할 수 있음을 입증했다는 데 의미가 있다"며 "실제 생활과 산업 현장의 다양한 기기에서 신뢰하고 사용할 수 있는 물리적 인공지능(피지컬 AI)의 기반을 마련할 것"이라고 말했다.
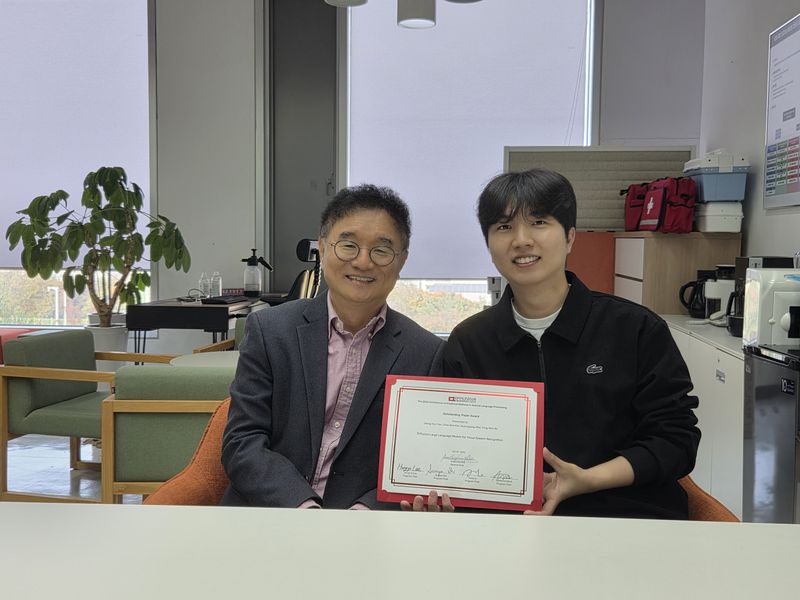
이번 연구에는 KAIST 전기및전자공학부 여정훈 박사후연구원이 제1저자로, 김채원·라형섭 박사과정 연구원이 공저자로, 노용만 교수가 교신저자로 참여했다. 논문은 자연어 처리 분야의 주요 국제학술대회인 'EMNLP 2026'에서 우수논문상(Outstanding Paper Award)을 수상했다.
[email protected] 연지안 기자