모레, AI 추론 처리량 최대 1.66배 높였다…최적화 기술 공개
[파이낸셜뉴스] 인공지능(AI) 인프라 솔루션 기업 모레가 대규모 언어모델(LLM)의 추론 처리량을 최대 1.66배 높이는 기술을 공개했다. 실제 AI 서비스에서 발생하는 데이터를 활용해 추론 과정을 지속적으로 최적화하는 방식이다. 기존 컴퓨팅 자원의 활용 효율을 높여 AI 서비스 운영에 필요한 연산 부담을 줄일 수 있을 전망이다.
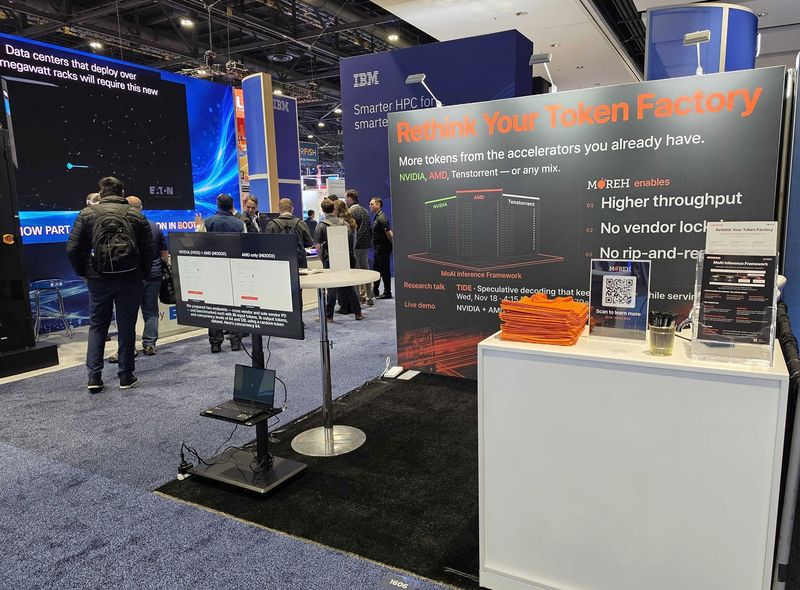
20일 업계에 따르면 모레는 최근 미국 시카고에서 열린 고성능 컴퓨팅(HPC) 컨퍼런스 '슈퍼컴퓨팅 2026(SC26)'에서 자기 개선형 추론 프레임워크 '타이드(TIDE)'를 첫 공개했다.
타이드는 대형 AI 모델이 답변을 생성하는 과정에서 만들어지는 데이터를 활용해 보조 모델을 지속적으로 개선하는 기술이다. 이용자의 질문 유형과 작업 환경이 달라져도 추론 과정이 이에 맞춰 최적화되도록 설계됐다.
핵심은 '추측 디코딩' 기술이다. 상대적으로 작은 보조 모델이 여러 개의 토큰을 먼저 예측하면 대형 모델이 이를 한 번에 검증하는 방식으로, 답변 생성에 필요한 시간을 줄일 수 있다.
기존 방식은 실제 이용자의 질문 유형이 보조 모델의 학습 패턴과 달라지면 예측 정확도가 떨어지는 문제가 있었다. 타이드는 대형 모델의 추론 과정에서 생성되는 내부 정보를 재활용해 보조 모델을 점진적으로 학습시킨다. 별도의 학습 데이터를 만들기 위해 대형 모델을 다시 실행할 필요가 없어 추가적인 연산 부담을 줄일 수 있다.
추론 성능 개선 효과와 보조 모델의 예측 정확도도 실시간으로 확인한다. 성능 개선 효과가 낮을 때는 불필요한 연산을 줄이고, 작업 유형이 달라져 예측 정확도가 떨어지면 새로운 데이터를 수집해 보조 모델을 다시 최적화한다.
모레가 발표한 연구 결과에 따르면 타이드는 추측 디코딩을 적용하지 않은 기존 추론 방식 대비 AI 추론 처리량을 최대 1.66배 높였다. 기존 온라인 학습 방식과 비교하면 보조 모델의 학습 시간은 최대 3.02배 단축했다.
서로 다른 제조사의 그래픽처리장치(GPU)를 함께 활용하는 환경에서도 성능 개선 효과를 확인했다. 엔비디아 H100 GPU를 대형 모델 추론에, AMD 인스팅트 MI250 GPU를 보조 모델 학습에 활용한 결과 동일한 GPU 자원을 모두 추론에 투입하는 방식보다 전체 처리량이 최대 1.22배 증가했다.
이번 연구는 모레의 AI 추론 플랫폼 '모아이 인퍼런스 프레임워크' 개발 과정에서 축적한 기술을 기반으로 진행됐다.
모레는 엔비디아와 AMD의 GPU, 텐스토렌트 AI 칩 등 서로 다른 연산장치가 혼재한 데이터센터에서 작업을 효율적으로 배분하는 인프라 소프트웨어 '토큰 팩토리 OS' 개발에도 주력하고 있다.
조강원 모레 대표는 "AI 인프라 경쟁력은 단순히 고성능 GPU를 얼마나 많이 확보하느냐를 넘어, 주어진 컴퓨팅 자원을 얼마나 효율적으로 활용해 더 많은 AI 연산을 처리할 수 있느냐에 달려 있다"고 말했다.
[email protected] 장민권 기자





