드론 AI 오탐지 39% 줄였다… 재학습 없이 정확도 높여 [언박싱 연구실]
<71> 덕성여대 유제혁 교수팀
AI 보정 기법 'SATTA' 개발
7개 모델 조건 시험… 초소형 물체 정밀도 개선
잘못된 탐지 줄었지만 실제 물체 놓치는 경우는 늘어
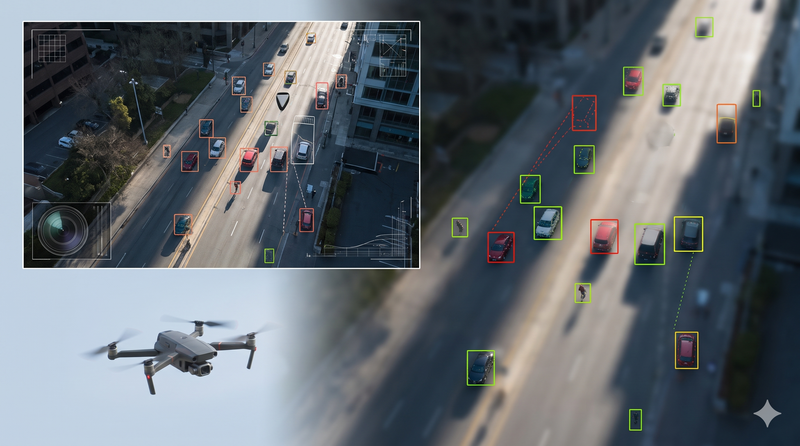
[파이낸셜뉴스] 덕성여자대학교 유제혁 교수팀이 드론 영상에서 사람이나 차량 같은 작은 물체를 잘못 찾아내는 오류를 줄이는 인공지능(AI) 보정 기법 'SATTA'를 개발했다. 기존 AI 모델을 다시 학습시키지 않고도 영상을 여러 조각으로 나눠 분석하는 SAHI 방식보다 오탐지를 35.5~39.1% 줄였다. 다만 잘못된 탐지를 줄이는 과정에서 실제 물체를 놓치는 경우는 일부 늘었다.
이번 연구는 드론으로 도로 교통량을 파악하거나 도심의 위험 요소를 살피고 재난 현장에서 사람을 찾는 등 영상 속 물체를 정확하게 알아내야 하는 분야에 활용될 가능성이 있다. 기존 AI 모델을 처음부터 다시 학습시키지 않고도 탐지 결과를 보정해 오류를 줄이는 방법을 제시했다는 점이 특징이다.
드론이 높은 곳에서 촬영하면 사람이나 차량이 영상 속에서 아주 작게 나타난다. 이 때문에 AI가 실제 물체를 놓치거나 배경을 물체로 잘못 판단할 수 있다.
이를 보완하기 위해 영상 전체를 작은 조각으로 나눠 분석하는 방식이 쓰인다. 조각난 영상에서는 작은 물체를 더 자세히 살필 수 있지만, 배경이나 그늘 등을 물체로 잘못 찾아내는 경우도 늘어난다. 작은 물체를 더 많이 찾으려다 오탐지도 함께 증가하는 것이다.
연구팀은 이런 문제를 줄이기 위해 SATTA를 고안했다. 연구에는 제1저자인 서해인 학생과 공동저자인 강예은 학생이 참여했다.
SATTA는 AI가 물체를 찾아낸 위치와 물체의 크기, 영상 조각의 가장자리와 얼마나 가까운지 등을 살펴 탐지 결과에 점수를 다시 매기는 방식이다. 특히 영상 조각의 가장자리에 걸쳐 있어 잘못 판단했을 가능성이 있는 결과에는 낮은 점수를 줘 오탐지를 걸러낸다. 기존 AI 모델을 다시 학습시키지 않고 탐지 결과를 조정하는 방식이다.
연구팀은 드론 영상 데이터셋인 'VisDrone2019-DET'의 시험용 이미지 1610장을 대상으로 성능을 비교했다. YOLO 계열의 세 가지 설정과 RT-DETR-L, DINO-R50, Cascade R-CNN, Faster R-CNN 등 다른 AI 탐지 모델 네 종류를 포함해 총 일곱 가지 조건을 시험했다.
대표 모델인 YOLO11n-960에 SATTA를 적용하자 이미지 한 장당 오탐지 건수는 기존 SAHI 방식의 140.8건에서 88건으로 37.5% 감소했다. AI가 물체라고 판단한 대상 가운데 실제 물체인 비율을 뜻하는 초소형 물체 정밀도도 0.055에서 0.082로 높아졌다. 초소형 물체를 얼마나 정확하게 찾아내는지 평가하는 지표인 XS AP50은 0.105에서 0.119로 상승했다.
시험 이미지 전체를 합산해도 오탐지는 22만6601건에서 14만1723건으로 8만4878건 줄었다. 특히 배경을 물체로 잘못 판단한 건수는 13만1801건에서 7만5179건으로 감소했다.
반면 실제로 존재하는 물체를 찾아내지 못한 건수는 2만1782건에서 2만3575건으로 1793건 늘었다. 실제 물체 가운데 AI가 찾아낸 비율인 재현율도 0.480에서 0.459로 낮아졌다. 오탐지를 줄이는 대신 일부 물체를 놓치는 경우가 늘어난 것이다. 따라서 오탐지를 줄이는 것이 중요한 상황에서는 도움이 될 수 있지만, 실제 물체를 최대한 많이 찾아내야 하는 상황에서는 이런 변화도 함께 고려해야 한다.
이번 연구는 덕성여대 데이터사이언스학과 학부생들이 주도적으로 참여했다. 논문은 컴퓨터 비전 분야 국제학술대회인 'WACV 2027(Winter Conference on Applications of Computer Vision)'의 평가 및 데이터셋 트랙 논문으로 채택됐다.
[email protected] 김만기 기자