AI 부작위 편향·안전성 구멍, 숭실대 학부생들이 메웠다
AACL-IJCNLP 2026 논문 4편 채택… 3편은 학부생 주도 연구
LLM 도덕적 편향 완화부터 AI 에이전트 사전 위험 차단 기술까지
[파이낸셜뉴스] 생성형 인공지능(AI)이 가진 고질적인 한계인 '도덕적 편향'과 '속마음과 말의 불일치', '실행 위험성' 문제에 대한 해결책을 국내 대학 학부생들이 주도적으로 찾아냈다.
숭실대학교는 소프트웨어학부 박찬준 교수팀의 논문 4편이 자연어처리 분야의 권위 있는 국제 학술대회인 'AACL-IJCNLP 2026'에 채택됐다고 8일 밝혔다. AACL-IJCNLP는 전산언어학회(ACL) 아시아·태평양 지부와 국제자연어처리가 공동 개최하는 주요 학술 행사다.
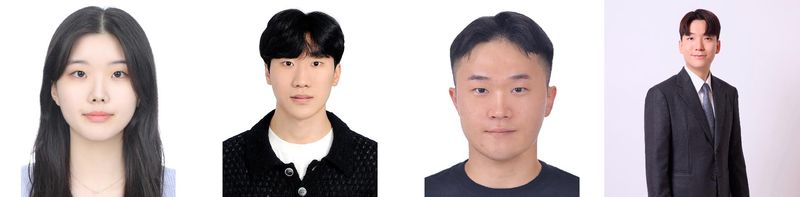
특히 이번에 채택된 논문 중 3편은 석·박사 과정이 아닌 숭실대 자연어처리 연구실 소속 학부생 연구원들이 제1저자 및 공동 제1저자로 연구를 주도해 거둔 성과다.
학부생 연구팀은 인공지능 대형언어모델(LLM)이 현장에서 일으키는 실질적인 문제점들을 집중 분석했다.
우선 이시현 연구원은 AI가 난감한 도덕적 갈등 상황에 직면했을 때, 직접 해결 행동을 취하기보다 상황을 그냥 방치하는 '부작위 편향(omission bias)'을 보인다는 점을 밝혀냈다. AI에게 답변을 내놓기 전 도덕적 원칙을 스스로 떠올리도록 유도하면 이러한 편향을 줄일 수 있다는 가능성도 함께 제시했다.
추교준 연구원은 AI의 '속마음과 말' 사이에 존재하는 차이를 파악했다. AI 내부 구조에는 문제를 해결하는 데 필요한 기능과 정보가 잘 정리되어 있음에도, 이를 사람의 언어로 설명하도록 요청하면 답변의 정확도가 크게 떨어지는 현상을 확인했다. AI가 알고 있는 내용과 이를 실제로 설명하는 능력 사이에 격차가 있음을 명확히 밝혀낸 것이다.
조성현 연구원은 도쿄대 연구진과 함께 AI 에이전트가 사용자의 명령을 수행하기 전, 그 행동을 나중에 취소하거나 원상복구할 수 있는지 미리 계산하는 안전 시스템(POLAR)을 개발했다. 실수로 중요한 데이터를 삭제하거나 돌이킬 수 없는 결제를 진행하는 등 위험한 명령 실행을 사전에 차단하는 기술이다.
연구를 지도한 박찬준 교수는 "이번 AACL-IJCNLP 2026에서 연구팀의 논문 4편이 채택됐고, 그중 3편이 학부생 주도 연구라는 점에서 특히 의미가 크다"며, "학생들이 학부 과정부터 스스로 연구 문제를 정의하고 실험을 설계하며, 국내외 연구자와의 협업을 통해 연구를 완성해 가는 경험이 중요하다"고 강조했다. 박 교수는 이어 "세 학생 모두 대학원에서 연구를 이어갈 예정인 만큼, 이번 성과가 장기적인 연구 성장의 출발점이 되길 기대한다"고 말했다.
한편 이시현·추교준·조성현 연구원은 학부 졸업 후 숭실대 대학원에 진학해 박찬준 교수의 지도 아래 자연어처리 분야 연구를 지속할 계획이다.
[email protected] 김만기 기자