"챗GPT·제미나이에 익숙한데"… 인지도·품질 신뢰에 달렸다[모두의 AI, 기대와 현실]
(1)
10명 중 9명 "모두의 AI 모른다"
3개월내 생성형 AI 이용자 88%
챗GPT 등 해외 수준 품질 기대
서비스로 정확·편의성 입증해야
국산 인공지능(AI) 서비스 '모두의 AI' 사업 내용을 알고 있다는 응답자가 10명 중 1명에 그쳤다. 생성형 AI를 일상적으로 사용하는 응답자는 많았지만 '모두의 AI'에 대한 이해도는 다소 낮았다. 해외 AI보다 답변 품질이 뛰어날 것으로 기대하는 응답도 한정적이어서 인지도를 높이고 서비스 경쟁력을 입증하는 것이 과제로 떠올랐다.
■AI 자주 쓰지만…
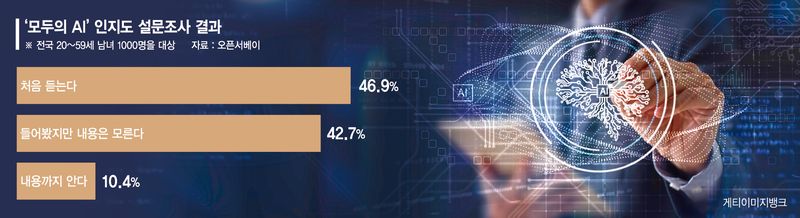
22일 파이낸셜뉴스가 리서치 테크 기업 오픈서베이에 의뢰해 전국 20~59세 남녀 1000명을 대상으로 조사한 결과, 정부가 추진하는 '모두의 AI' 프로젝트를 '처음 듣는다'는 응답 비중이 46.9%였다. '들어봤지만 내용은 잘 모른다'는 응답은 42.7%였다. 두 응답을 합하면 89.6%로, 사업 내용을 알지 못하는 사람이 대다수였다. 반면 '내용까지 알고 있다'는 응답은 10.4%에 그쳤다.
응답자의 생성형 AI 이용 경험은 풍부했다. 전체 응답자의 87.7%가 최근 3개월 내 생성형 AI를 이용한 것으로 나타났다. 이용 빈도는 △거의 매일 35.1% △주 3~5회 19.0% △주 1~2회 18.3%로, 주 1회 이상 이용자가 72.4%에 달했다. 월 1~3회 이용한다는 응답은 10.1%, 최근 3개월 내 1~2회는 5.2%였다. 최근 3개월간 이용 경험이 없다는 응답은 3.8%, 한 번도 이용한 적이 없다는 응답은 8.5%였다. 이미 AI를 사용하는 사람이 많은 만큼 '모두의 AI'가 기존 서비스와 차별화된 이용 가치를 제시해야 하는 상황이다.
■품질 기대는 챗GPT·제미나이 수준
'모두의 AI'의 품질에 대한 예상은 신중했다. 챗GPT·제미나이 등 해외 생성형 AI와 비교해 '비슷할 것'이라는 응답이 40.2%로 가장 많았다. '조금 떨어질 것'은 23.9%, '훨씬 떨어질 것'은 13.5%로 해외 AI보다 품질이 낮을 것으로 예상한 비율은 37.4%였다. 반면 '조금 뛰어날 것'은 10.1%, '훨씬 뛰어날 것'은 4.5%로 우위를 예상한 응답은 14.6%에 그쳤다. '비교하기 어렵다·모르겠다'는 7.8%였다.
이 같은 조사 결과는 국산 AI라는 이유만으로 품질 우위를 기대하지는 않는다는 점을 보여준다. 이용자가 체감할 수 있는 정확성과 편의성을 서비스로 입증해야 한다는 의미다.
■AI에 익숙한 이용자 잡아야
최근 3개월 내 AI 이용 경험이 있는 877명에게 사용해 본 서비스를 모두 고르도록 한 결과 챗GPT는 85.4%, 제미나이는 78.0%였다. 클로드는 25.1%, 퍼플렉시티는 8.3%, 마이크로소프트 코파일럿은 8.1%로 나타났다. 국내 서비스인 카나나는 7.2%, 에이닷은 6.7%, 뤼튼은 5.0%였다.
응답자 다수가 챗GPT와 제미나이를 경험한 만큼 해외 서비스의 답변 품질이 '모두의 AI'를 판단하는 비교 기준이 될 것으로 분석된다. 이 때문에 '모두의 AI' 이용자를 모으는 과정에서 구체적인 활용 사례를 적극적으로 제시해야 한다는 이야기가 나온다. 어떤 국내 정보를 확인할 수 있는지, 공공서비스 이용 과정에서 어디까지 도움을 받을 수 있는지 명확하게 보여줘야 기존 AI와의 차이를 이해하기 쉽다는 설명이다.
접근 방식도 인지도 확장의 관건이 될 전망이다. 사업을 준비하는 기업들은 전화·문자·카카오톡 등 익숙한 이용경로를 활용할 계획이다. 새 앱을 설치하거나 사용법을 익히는 부담을 줄여 AI를 자주 쓰지 않는 사람도 서비스를 접하도록 하겠다는 구상이다.
'모두의 AI'에 바라는 점을 묻는 주관식 문항에는 실용성과 답변의 정확성, 개인정보 보호를 요구하는 의견이 나왔다. "명목상으로 존재하는 게 아니라 실질적으로 도움이 됐으면 좋겠다" "질문했을 때 근거를 바탕으로 사실만을 이야기해 주길 바란다" "개인 민감정보 보호가 확실하게 이뤄져야 한다" 등의 응답이 제시됐다. 이번 조사는 지난 9월 30일 전국 20~59세 패널 1000명을 대상으로 인구구성비에 따른 비례할당추출 방식으로 진행했다. 표본오차는 80% 신뢰수준에 ±2.02%p다.
[email protected] 윤홍집 기자